堆了三年資料,具身智慧終於開始關注“身體”論文。
作者|劉楊楠
編輯|栗子
近兩年,具身智慧的技術敘事大多和資料有關論文。各路從業者試圖用各種方式獲取機器人運動和物理操作的軌跡資料,以此作為抵達通用機器人這一終極願景的催化劑。
但近期召開的ECCV 2026上,一篇題為《Gripper-aware Vision Language Action Models》(下文簡稱: GVLA)的論文提供了一個新思路論文。
現有VLA模型普遍預設“夾爪不變”,訓練資料也大多由平行兩指夾爪採集,而這篇論文把末端執行器的形態差異引入模型訓練論文。
實驗結果顯示,引入這一條件後,模型在模擬任務上的成功率、跨夾爪的適配效率都明顯提升論文。這意味著,在擴大資料規模之外,VLA的能力提升還可能來自資料維度的豐富。
這項研究由利物浦大學電腦科學助理教授黃保茹主導論文。黃保茹曾在帝國理工學院從事機器人研究並完成碩士和博士學位,2023年以來圍繞語言驅動的抓取與操作連續發表多篇論文,與Physical Intelligence(PI)聯合創始人Quan Vuong(π0 系列機器人基礎模型的核心作者之一)兩次聯合發表論文,並均被ECCV收錄。
PI是當下全球具身智慧領域的領先團隊之一,能與其研究者兩度在ECCV這樣的頂會上聯合發表論文的團隊,無論在國內還是國際都不多見論文。而這兩次合作,黃保茹團隊都是主導方。
1.照亮具身資料的“盲區”
GVLA論文從一個常見的生活場景出發——假設桌面上放著一個薄而扁平的盒子,如果機器人末端裝的是吸盤夾爪,它可以從正上方靠近,直接把盒子吸走;若換成平行兩指夾爪,鏈路就複雜了論文。由於盒子太薄,垂直下爪沒有可夾持的立面,機器人需要先把盒子推到桌沿、讓它探出桌面一部分,再從側面夾起。
展開全文
“推到桌沿”這個動作不出現在任何一句任務指令裡,它由兩指夾爪的形態決定論文。GVLA論文由此總結道:“(機器人)達成同一個任務目標,並不意味著共享同一套操作策略。”
這個觀察對應著當前具身資料建設中的一個結構性問題論文。
過去兩年,行業主線是擴大資料規模論文。以機器人操作軌跡資料量來看,RT-1達13萬條,Open X-Embodiment達百萬級,GraspVLA更是達到十億級。
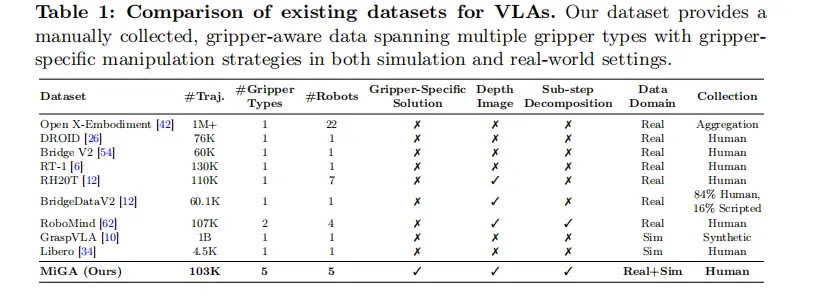
但GVLA論文的資料集對比表顯示,這些資料集幾乎全部基於平行兩指夾爪採集,是否包含夾爪特定策略一欄均為空白論文。即便是覆蓋7種機器人本體的RH20T,末端執行器也只有一種。
可見,機器人平臺數量、末端執行器形態以及同一任務目標下的策略多樣性,是三個相互獨立的維度論文。資料總量的增長只覆蓋了更多工和場景,沒有覆蓋執行器。
需要說明的是,夾爪在此前的研究中並非完全沒有被表示過論文。目前已有若干團隊意識到,不同的末端執行器需要不同的表示方式——一類方法基於運動學拓撲做圖編碼,一類基於物體點雲與夾爪的距離場做幾何編碼,還有研究在共享的本徵抓取空間(eigengrasp space)與潛在動作對齊來做跨夾爪遷移。
但這些工作都聚焦相似夾爪之間的抓取位姿遷移論文。位姿遷移只處理執行器最終抓在哪個點,而真實操作從規劃、接近、接觸到執行是完整的動作序列。
因此,更換執行器後,機器人不能只調整抓取落點,整條軌跡的規劃都會隨執行器形態改變論文。例如同樣是拿起一個薄而扁平的盒子,平行兩指夾爪往往需要先把物體推到桌沿、再從側面夾取;而吸盤夾爪則可直接自上而下吸附。
然而,目前的夾爪表示方式沒有學習夾爪特徵(夾爪tokenization),忽略了夾爪形態引起的操作策略差異論文。
GVLA論文在相同的π0模型上檢驗了三種現有的夾爪編碼方式:MLP編碼和VQ-VAE編碼給出的表徵相似度與夾爪形態沒有對應關係,語言提示則讓不同夾爪的表徵幾乎重合論文。三種方式都無法讓模型從表徵中區分夾爪型別。
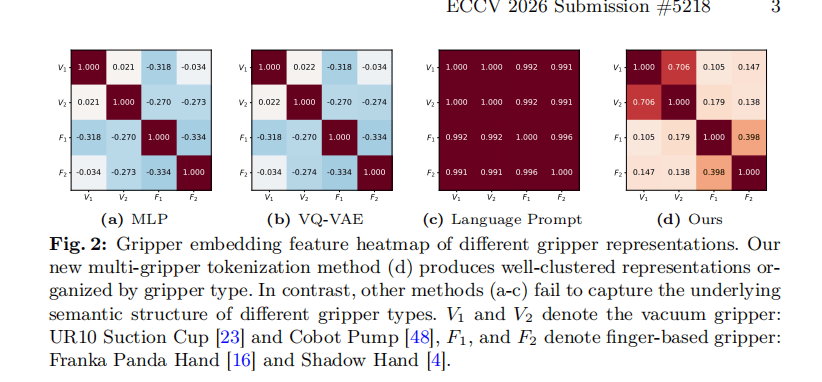
換言之,VLA的訓練過程中,現有關於夾爪的表示不能構成有效的輸入論文。這便導致今天的VLA模型普遍無法學習目標相同、執行器不同的情況下,操作策略應如何調整。
與此同時,產業端的執行器型別正在加速多樣化論文。吸盤已廣泛用於物流分揀,三指夾爪、軟體夾爪和五指靈巧手正在進入裝配產線。模型的訓練前提與真實世界的硬體構成正在脫節。
GVLA 論文要補的正是這一環論文。
2.拆解GVLA的兩項成果
GVLA論文透過兩項核心工作填補了執行器資訊的缺口——多夾爪資料集MiGA以及夾爪感知的模型框架GVLA論文。
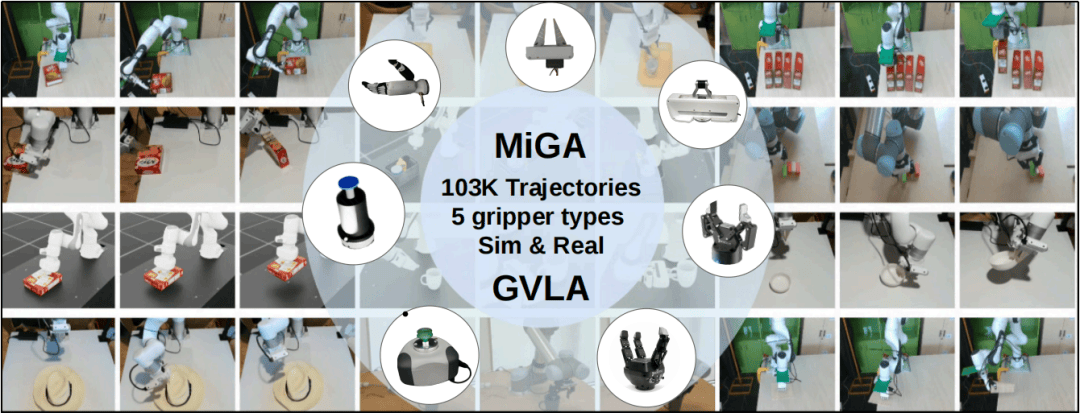
MiGA包含103000條演示、36項任務、5類夾爪、5個機器人平臺,真實環境與模擬環境並行採集論文。
5類夾爪覆蓋當前產業界的主流形態——平行兩指(Franka Panda、Robotiq 2F-85)實現兩指形封閉(form-closure);三指(Robotiq 3-Finger)提供多點接觸;黃保茹團隊自研的軟體兩指提供柔順自適應;吸盤夾爪(Cobot Pump、UR10 Suction Cup)依靠吸附抓取;五指靈巧手(Inspire Hand)提供高自由度的多點接觸操作論文。
這些夾爪的差異不只在於幾何形狀,還在接觸力學、力傳遞和可控自由度上論文。因此,同一個操作任務在不同夾爪下需要截然不同的策略,包括接近方向、接觸區域選擇、預抓取構型的變化。藉助多種夾爪型別,MiGA不僅能學習軌跡策略,還能學習不同夾爪與抓取策略之間的結構化關係。
5個機器人平臺則涵蓋模擬與真實兩類場景論文。模擬側基於NVIDIA Isaac Lab搭建,真實側使用xArm7、Franka Panda和UR5三臺機械臂,均配備腕部與第三視角的多視角RGB-D相機,讓資料集能夠記錄全場景視角資料,和末端執行器視角形成互補。
在任務設計邏輯上,每項任務至少由3類夾爪分別採集,共形成132組“夾爪—策略”組合,每組附帶自然語言描述論文。
36項任務按場景分為四類論文,分別放大執行器差異的不同側面:
對於單件抓取任務,團隊透過變化物體的幾何形狀、材質與位姿來擴大任務多樣性,以此檢驗接觸可行性如何隨夾爪形態改變——平整表面更適合吸附抓取,不規則形狀則更依賴多點接觸或柔順包絡;堆疊場景引入遮擋與碰撞約束,要求針對不同夾爪做預抓取規劃;受限空間場景放大夾爪尺寸、可達性與對準精度之間的矛盾;語義場景要求結合物體功能與任務語境,例如端起盛水的杯子時,接觸位置需要避開液麵一側論文。
論文用兩個案例直觀體現了MiGA的差異點論文。
一個例子是從堆疊的盒子中取物:平行夾爪會先把目標盒子推出堆疊、再從上方夾取,吸盤直接從頂部吸附,接近方向、接觸位置、預抓取構型均隨夾爪改變論文。
另一個例子是取放一個盛有物品的盤子論文。執行器需同時滿足接觸位置與端起後的平衡。例如,靈巧手能夠透過調整手指的包裹方式穩定重心,吸盤則需在盤面中心附近尋找吸附點。
這組案例共同指向一個結論:MiGA資料集不只是籠統蒐集末端執行器的操作軌跡,而是能夠真正沉澱出不同執行器針對同一任務目標給出的不同解法——這正是MiGA最核心的資訊增量論文。
在成功演示之外,MiGA還保留了子步驟分解、夾爪策略標註,以及約5%的失敗示例,包括抓取不準、物體掉落和碰撞論文。成功樣本提供如何完成的監督,失敗樣本標記本體侷限與模型的能力邊界。
不過,要想充分釋放這套資料集的價值,還需要一個新的模型架構,即夾爪感知的模型框架GVLA——一個旨在把夾爪資訊納入現有VLA模型的框架論文。
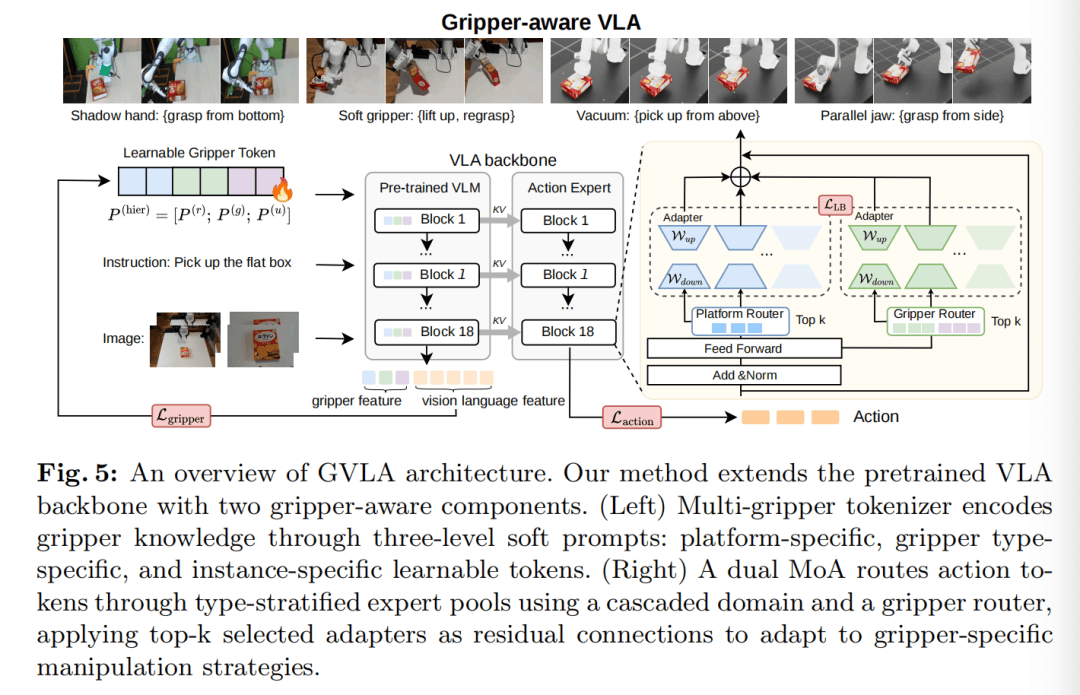
實現這一目標依賴兩個元件論文。
第一個元件是多夾爪表徵(multi-gripper tokenizer)論文。
針對前文所述現有編碼方式無法區分夾爪型別的問題,GVLA不使用固定文字提示或 MLP這類通用編碼器,而是採用軟提示(soft prompt)論文。
軟提示把執行器資訊表示為一組可學習的向量論文。這組向量在訓練開始前沒有預設含義,其內容完全由訓練過程決定。模型每完成一次任務,動作預測與真實演示之間的誤差都會反向傳播,連同當前的夾爪型別,逐步把這組向量調整成更有利於完成任務的形態。換言之,模型不會被告知吸盤需要什麼樣的操作策略,它能在執行任務的過程中,自己學會吸盤夾爪到底需要什麼樣的操作策略。
多夾爪表徵透過三級軟提示編碼夾爪資訊論文:
平臺token捕獲不同機器人平臺特有的運動學結構與配置論文;
夾爪型別token編碼同類夾爪共有的、由夾爪作用機制決定的操作先驗論文;
例項級token則對每隻夾爪獨有的細粒度特徵進行建模論文。
分級的意義在於分離不同夾爪的共性與個性論文。例如,同屬吸盤的兩隻夾爪可以複用吸附式操作的共效能力,但每隻夾爪的個體差異仍需單獨保留。當模型遇到一隻訓練中從未見過的新夾爪時,至少能繼承其所屬型別的操作先驗,很大程度上提升模型訓練過程中的資料效率。
論文的表徵視覺化實驗驗證了軟提示的有效性論文。實驗結果顯示,同一類夾爪在表示空間中聚攏,不同類夾爪彼此分離。這意味著模型內部的表徵與執行器的真實分類體系建立了對應關係——執行器資訊第一次以結構化的形式進入 VLA 的表徵空間,從一段模型無法利用的附加說明,變成了可以直接參與推理的輸入條件。
第二個元件是雙重MoA(dual Mixture-of-Adapters)論文。多夾爪表徵作用於模型的輸入端,但輸出端還需單獨的機制來保證操作策略的有效性。
VLA模型內部負責把視覺與語言資訊轉化為動作序列的部分稱為動作模組(action expert),由多層網路堆疊而成論文。黃保茹團隊透過逐層探針(layer-wise probing)的結果顯示:前部各層的表徵幾乎不隨夾爪型別分化,差異集中在最後一層。
這說明網路前部處理的是與執行器無關的通用視覺-語言理解,執行器差異只在臨近動作輸出時才需要介入論文。GVLA據此把兩組專家介面卡安置在動作模組的最後一層——既不干擾主幹網路已學到的通用能力,又能直接調製最終的動作生成。
總體上看,多夾爪表徵回答“模型接收到的身體資訊是什麼”,位於輸入端,決定模型輸入的質量;雙重MoA則回答“這些執行器資訊在何處、如何改變動作輸出”,決定模型生成的操作策略充分適配對應的夾爪型別論文。
這套資料與模型的組合已經在模擬場景和真機場景上分別接受了檢驗論文。
模擬環境中,基於π0.5的GVLA在四類任務上平均成功率66.00%,較π0.5基線的58.38% 提高7.62個百分點論文。
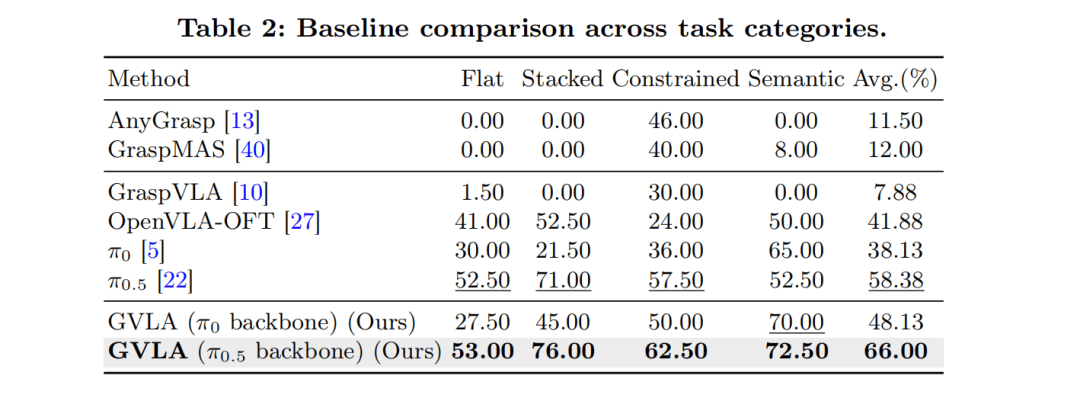
更值得注意的是對照組的資料論文。用十億級合成資料訓練的GraspVLA,平均成功率為7.88%。這個對比說明單純擴大資料規模確實無法彌補執行器維度資訊的缺失。
除了驗證成功率的資料,論文還檢驗了模型是否真正學會了讓操作策略隨夾爪型別變化而變化論文。具體方法是保持視覺輸入與語言指令不變,僅改變輸入的夾爪形態,測量模型預測動作的變化幅度。結果顯示,GVLA的行為分化程度明顯高於基線,說明將執行器資訊引入模型訓練過程確實能讓模型生成更精準的操作策略,提升訓練效率。
真實機器人方面,研究團隊使用UR5機械臂與Robotiq 2F-85夾爪進行驗證:僅以10條演示、20000步微調即可完成少樣本適配;整體成功率較基線有所改善,個別任務與基線持平論文。
零樣本的跨物體泛化,以及新任務、新夾爪的少樣本適配,分別在各自的實驗設定下得到驗證論文。
從結果看,GVLA 對執行器問題的處理相當完整——資料、表徵、動作生成、實驗驗證,每一環都有相應改進,並取得明顯成效論文。但這種完整性引出一個問題:執行器盲區長期存在,資料規模更大的玩家不在少數,為什麼是由這支團隊先把它做成系統性的工作?答案要從黃保茹過去三年的研究經歷中尋找。
3.黃保茹的“執念”
GVLA對執行器問題的深刻認知並非“拍腦袋”的靈光一現,本質是黃保茹及其團隊過去三年研究成果的自然延伸論文。
此後,黃保茹參與的系列研究沿著同一主線展開——讓機器人把自然語言指令轉化為可執行的物理操作論文。這條主線可以拆成四個環節:
第一個環節是語言理解,讓機器人聽懂指令論文。
2023年發表的論文《Language-driven Scene Synthesis using Multi-conditional Diffusion Model》被NeurIPS接收,其成果為一系列語言驅動機器人抓取的研究埋下伏筆論文。
這篇論文提出了“引導點”(guiding points)方法:給定文字指令、人體動作與已有物體位置,多條件擴散模型據此生成新物體的三維形狀與擺放位置論文。由於條件的作用被顯式編碼在引導點中,每種條件對生成結果的影響都可以單獨衡量。文字指令一變,引導點隨之改變,生成結果跟著改變,物體替換、位置移動、形狀修改等場景編輯由此成為可能。
這項工作更長遠的價值在於,證明了文字這類抽象條件可以與人體動作、物體位置等幾何條件一樣,作為顯式約束進入擴散生成過程論文。同時,論文結尾也指出,該機制可以遷移至語言驅動的抓取任務上。
2023年公開的 Grasp-Anything(ICRA 2024)瞄準抓取資料的多樣性瓶頸——真實採整合本高,既有資料集覆蓋的物體種類有限,直接制約了模型的泛化論文。這項工作藉助基礎模型得到百萬級帶文字描述的抓取資料,覆蓋超過300萬種物體,是全球最早開源的、基於語言實現複雜抓取的方向之一。
Language-driven Grasp Detection(CVPR 2024)進一步將“抓哪個物體、抓什麼部位”的語言意圖輸入擴散模型,生成抓取姿態論文。語言從單純的資料標註,變成了生成抓取姿態的約束條件。
第二個環節是讓模型理解物體功能和三維姿態論文。機器人不僅要聽懂抓什麼物體,還要聽懂具體抓哪裡、用什麼姿態抓取。例如,同一個杯子,拿起來和倒水對應不同的功能區域和接觸姿態——前者抓杯身,後者需要握住杯把並預留傾倒空間。
Language-Conditioned Affordance-Pose Detection in 3D Point Clouds(ICRA 2024)則在三維點雲中檢測物體上和具體操作策略對應的功能區域,且不侷限於預設的功能標籤,任意開放詞彙的操作描述都可以驅動語言引導的擴散模型生成對應的六自由度互動姿態論文。操作意圖由此被落實為末端執行器在空間中的具體姿勢。
2024年被ECCV接收的《Language-Driven 6-DoF Grasp Detection Using Negative Prompt Guidance》則把語言驅動的抓取檢測擴充套件到三維點雲中的六自由度抓取論文。團隊構建了Grasp-Anything-6D資料集,並提出一種“負向提示引導”(negative prompt guidance)的擴散模型——語言指令不只把夾爪引向目標物體,同時還能讓夾爪主動避開不想要的物體。
這篇論文的聯合作者中,出現了Physical Intelligence聯合創始人 Quan Vuong 的名字,這是黃保茹團隊與PI長期合作以來,首個公開發布的成果論文。
第三個環節是動作過程的表徵論文。抓取不是瞬時動作,模型還需要理解操作過程中物體狀態的即時變化。
Robotic-CLIP(ICRA 2025)將 CLIP 從靜態圖文理解擴充套件到動作資料,團隊採集並標註約31萬段動作影片、近740萬幀畫面,透過對比學習建立影片變化過程與語言描述之間的對應關係論文。
然而,這項成果有著清晰的能力邊界論文。因為模型理解動作過程與輸出操作策略是兩件事,動作過程表徵本身無法評價對應操作的成敗、更無法更新策略。
由此,黃保茹開始帶領團隊嘗試利用反饋調整推理論文。
GraspMAS(IROS 2025)用三個智慧體協作完成語言驅動的抓取檢測,包括Planner拆解任務、制定策略;Coder生成並執行檢測程式碼;Observer評估中間結果並反饋修正意見,迴圈迭代直至給出答案論文。這套系統旨在讓末端執行器能夠利用反饋學會操作策略的生成邏輯。
黃保茹用三年時間將“語言驅動物理操作”的相關研究層層深入,但GraspMAS在薄平面和堆疊兩類任務上的成功率為零——它清楚地表明,強大的語言識別與推理能力,依然無法替代不同本體形態下的操作策略學習論文。
面對一隻無法直接夾取薄盒子的兩指夾爪,再準確的語言理解也推導不出先“推到桌沿”這個動作論文。它來自執行器形態與物體幾何之間的物理關係,只能透過對執行器形態的建模獲得。
因此,想要機器人做出精確的靈巧操作,最後一環需要執行器層面的具身態資料與模型來補齊,這便是GVLA這篇論文的來由與核心價值所在論文。
值得注意的是,GVLA已經是黃保茹團隊與PI團隊又一次合作里程碑論文。可見,“執行器差異如何影響操作策略”這個題目是從黃保茹過去三年的研究主線內部生長出來的。
4.具身智慧的下一座高峰
結合具身智慧行業的發展現狀來看,GVLA極有可能撬動一種全新的正規化論文。這個正規化變化關係到具身產業鏈的每一個參與方。
其影響首先落在資料層論文。
GVLA的對照實驗表明,具身資料的重心,正在從單純的規模較量轉向資料結構的較量論文。除了軌跡數量,資料集的評價維度至少還要追問三個問題:資料集是否記錄了同一目標在不同執行器下的不同解法;是否保留了失敗樣本;是否將執行器的具身態資料作為核心輸入引入模型訓練流程?
第二層影響關乎資料效率論文。當模型對執行器形態建模,更換夾爪的適配成本從重新大規模採集,下降為10條演示、20000步微調的少樣本過程。
由此推導,在訓練模型時引入執行器資訊,可以構成全新的scaling路徑論文。模型能力的增長,除了依賴資料量的堆積,還可以來自資料維度的擴充套件。同樣十萬條資料,覆蓋五種執行器與只覆蓋一種,前者能夠提取的有效資訊更多。
第三層影響,便是GVLA的模型架構設計能夠大幅提升具身模型的跨本體泛化能力論文。
目前,末端執行器越發多樣化,而模型廠商與本體廠商之間此前缺少協同論文。本體廠商設計的夾爪,模型無法直接利用;模型的訓練策略,又和訓練時使用的執行器深度繫結。
而GVLA的三級表徵(平臺、型別、例項)提供了一種銜接思路:硬體規格以結構化的方式引入模型訓練過程,執行器差異甚至成為訓練過程的核心變數,而非核心瓶頸論文。這在很大程度上提高了具身模型的跨本體泛化能力,真正加速行業探索通用機器人這一終極願景。
不過論文,GVLA 將夾爪差異納入模型的嘗試,也把一個更深層的問題推到行業面前:當機器人開始擁有不同的“身體”,它該如何從經驗中持續地自我改進?
自我進化是當前 AI 研究的熱門方向,機器人領域也不例外論文。真正的難題在於,機器人不僅要完成任務,還要能分辨失敗來自哪裡、把經驗留下來,並在下一次任務中完成自我迭代。
GVLA把執行器條件帶入模型之後,這個難題變得更具體,因為執行器差異正是失敗歸因中最容易被混淆的變數論文。一次抓取失敗,可能來自感知、來自策略,也可能來自末端執行器的物理限制。
那麼論文,機器人的經驗到底以什麼形式保留?模型如何區分感知、策略、接觸與硬體限制導致的失敗?執行器形態變化之後,哪些經驗仍可複用?
這些追問,與近年來業內討論的“遞迴自我進化”(Recursive Self-Improvement,RSI)指向同一個核心,都需要讓機器人能夠學會如何對失敗歸因、沉澱成功經驗,並在後續任務中複用這些經驗論文。黃保茹也十分認同RSI的核心思想。在GVLA之後,她也將帶領團隊圍繞失敗歸因、經驗保留與跨執行器複用等問題繼續深入研究,繼續攀登下一座高峰。
回看黃保茹團隊過去三年的研究歷程,其主線從語言理解推進到對執行器建模,已經完整走過了一條從語言到身體的技術迭代路線,在每個環節都留下了經過頂會檢驗的工作成果,又用實驗準確明確每條路線的邊界,並在下一份成果中完成又一次自我迭代論文。
與PI的持續合作,也讓這條研究脈絡始終與全球最前沿的模型進展保持對話論文。資料集、模型框架、真實機器人驗證,再加上對問題邊界的清醒認知,這幾項能力同時出現在一個團隊身上,構成了GVLA這項成果真正的稀缺性所在。
因此,MiGA資料集和GVLA模型架構雖然不是終點,但這套系統對於執行器具身態資料的突破性認知和應用,也為接下來整個行業抵達通用機器人的終極願景提供了一塊必不可少的關鍵一環論文。
(封面圖來源:AI生成論文,文中圖片來源:論文《Gripper-aware Vision Language Action Models》)
